JavaScript відіграє важливу роль в Інтернеті, оскільки дозволяє розширювати можливості сайтів і перетворювати їх на веб-додатки. Якщо у вас є такі додатки, ви можете допомогти пошуковим роботам індексувати їх, щоб ваш контент з’являвся в Пошуку Google і допомагав залучати і утримувати користувачів. Google Пошук обробляє код JavaScript за допомогою останньої версії Chromium. У зв’язку з цим ми можемо запропонувати вам поради щодо оптимізації такого коду.
З цього посібника ви дізнаєтеся, як ми скануємо та індексуємо веб-додатки на основі JavaScript і як оптимізувати такі додатки для Пошуку Google.
Обробка веб-додатків на основі JavaScript за допомогою робота Googlebot передбачає три основні етапи:
- Сканування
- Відмальовування
- Індексація
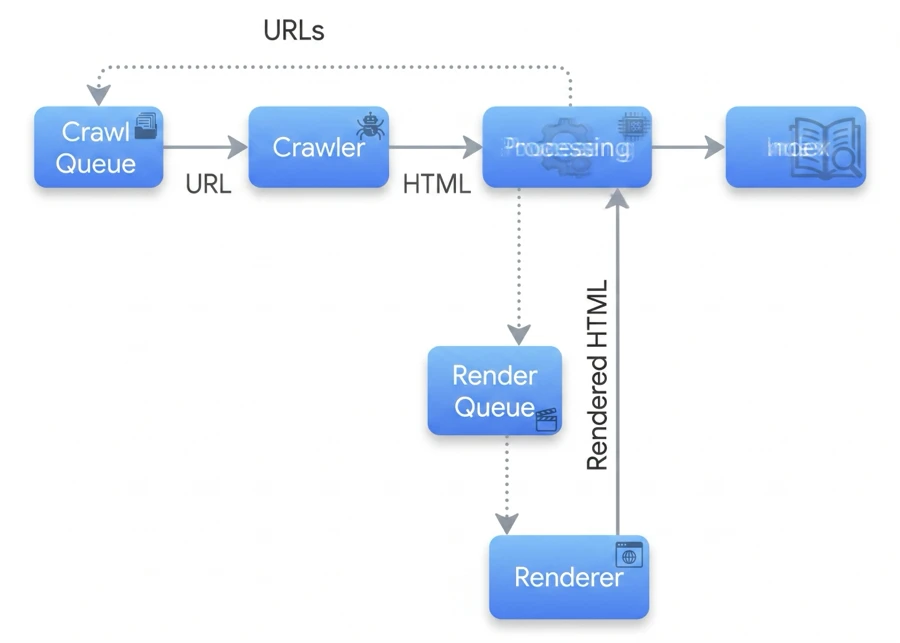
Робот Googlebot ставить сторінку в окремі черги для сканування та відображення. Неможливо точно встановити, в якому з них знаходиться сторінка в кожен окремий момент. Отримавши URL-адресу з черги сканування за допомогою HTTP-запиту, робот Googlebot спочатку перевіряє, чи дозволено сканування сторінки. Для цього він зчитує файл robots.txt. Якщо доступ до URL заборонений, Googlebot не надсилає відповідний HTTP-запит і пропускає цю URL-адресу. Пошук Google не обробляє код JavaScript на сторінках і в файлах, які заблоковані в налаштуваннях.
Потім Googlebot знаходить у отриманій відповіді інші URL-адреси, які задаються через атрибут href HTML-посилань, і додає їх у чергу сканування. Якщо ви не хочете, щоб робот Googlebot переходив за посиланнями, вкажіть для них атрибут nofollow.
Сканування URL і аналіз HTML-відповіді ефективні у випадку звичайних сайтів і сторінок, які відображаються на стороні сервера, коли весь вміст міститься в коді HTML з HTTP-відповіді. Однак на деяких сайтах використовується модель оболонки, при якій фактичний вміст сторінки не міститься у вихідному коді HTML, і щоб отримати його, роботу Googlebot необхідно виконати код JavaScript.
Якщо в заголовку або тегу meta з атрибутом robots немає заборони на індексування сторінки з кодом статусу HTTP 200, Googlebot ставить її в чергу на рендеринг. Сторінка може затриматися в черзі на кілька секунд (у деяких випадках на більш тривалий час). Коли у робота Googlebot достатньо ресурсів для обробки, він отримує від консольного браузера Chromium відрендерену сторінку з виконаним кодом JavaScript. Googlebot аналізує отриманий HTML-код, індексує його контент і ставить усі виявлені в ньому URL у чергу на сканування.
Ми рекомендуємо по можливості використовувати відмальовування на стороні сервера або попереднє відмальовування, оскільки в цьому випадку сайт буде завантажуватися швидше. Крім того, не всі роботи можуть виконувати код JavaScript.
Використовуйте унікальні заголовки та короткі описи сторінок
Унікальні інформативні елементи <title> і метаописи допомагають користувачам швидше знаходити потрібні результати пошуку. Задавати та змінювати елементи <title> і метаописи можна за допомогою JavaScript.
Як встановити канонічний URL
Тег link з атрибутом rel="canonical" допомагає Google знаходити канонічну версію сторінки. Задати канонічний URL можна за допомогою JavaScript. Однак ми не рекомендуємо використовувати JavaScript, щоб змінювати такий URL. Найкраще задавати канонічний URL за допомогою HTML, але якщо вам потрібно використовувати JavaScript, переконайтеся, що цей URL збігається з тим, який вказано у вихідному HTML-коді. Якщо ви не можете задати канонічний URL за допомогою HTML, не включайте його у вихідний код. Тоді можна буде використовувати JavaScript.
Сучасні браузери підтримують різні API, а мова JavaScript швидко розвивається. Робот Googlebot може не підтримувати деякі API і функції JavaScript. Щоб ваш код був сумісний з роботом Googlebot, дотримуйтесь наших рекомендацій щодо усунення проблем з JavaScript.
Якщо браузер не підтримує потрібні вам API, рекомендуємо використовувати диференціальний показ і поліфіли. Оскільки поліфіли доступні не для всіх функцій браузерів, рекомендуємо вивчити інформацію про обмеження в документації з поліфілів.
Використовуйте правильні коди статусів HTTP
Для отримання інформації про проблеми, що виникли під час сканування сторінки, робот Googlebot аналізує коди статусів HTTP.
Щоб робот Googlebot міг визначити, чи дозволено йому сканувати або індексувати сторінку, використовуйте зрозумілі коди статусів. Наприклад, якщо сторінку не знайдено, поверніть код 404, а якщо для доступу до сторінки потрібно увійти в обліковий запис – код 401. Також за допомогою кодів статусів HTTP можна повідомити роботу Googlebot про перенесення сторінки на нову URL, щоб ми оновили індекс.
Ознайомтеся з кодами статусів HTTP і дізнайтеся, в яких випадках їх потрібно використовувати.
Намагайтеся не допускати помилок soft 404 в односторінкових додатках
У клієнтських додатках, що складаються з однієї сторінки, маршрутизація часто виконується на стороні клієнта. У цьому випадку використовувати коди статусів HTTP може бути неможливо або незручно. Щоб при відмальовуванні та маршрутизації на стороні клієнта не виникала помилка soft 404, виконайте наступне:
- Налаштуйте переадресацію JavaScript на URL, для якого сервер повертає код стану HTTP
404. Приклад:/not-found. - Додайте на сторінки з помилками тег
<meta name="robots" content="noindex">, використовуючи JavaScript.
Зразок коду з переадресацією
fetch(`/api/products/${productId}`)
.then(response => response.json())
.then(product => {
  if(product.exists) {
    showProductDetails(product); // shows the product information on the page
  } else {
    // this product does not exist, so this is an error page.
    window.location.href = '/not-found'; // redirect to 404 page on the server.
  }
})
Посібник з коду
Зразок коду з тегом noindex
fetch(`/api/products/${productId}`)
.then(response => response.json())
.then(product => {
  if(product.exists) {
    showProductDetails(product); // shows the product information on the page
  } else {
    // this product does not exist, so this is an error page.
    // Note: This example assumes there is no other robots meta tag present in the HTML.
    const metaRobots = document.createElement('meta');
    metaRobots.name = 'robots';
    metaRobots.content = 'noindex';
    document.head.appendChild(metaRobots);
  }
})
Посібник з коду
Застосовуйте History API замість фрагментів
Googlebot виявляє посилання, тільки якщо вони задані в елементі HTML <a> з атрибутом href.
Якщо у вас односторінковий додаток з клієнтською маршрутизацією, для переходів між різними видами додатків використовуйте History API. Щоб робот Googlebot міг знаходити, обробляти та отримувати URL, не використовуйте фрагменти для завантаження різного вмісту сторінки. Нижче наведено приклад коду, який порушує наші рекомендації, оскільки при його використанні робот Googlebot не зможе правильно розпізнати URL:
<nav>
  <ul>
    <li><a href="#/products">Our products</a></li>
    <li><a href="#/services">Our services</a></li>
  </ul>
</nav>

<h1>Welcome to example.com!</h1>
<div id="placeholder">
  <p>Learn more about <a href="#/products">our products</a> and <a href="#/services">our services</a></p>
</div>
<script>
window.addEventListener('hashchange', function goToPage() {
  // this function loads different content based on the current URL fragment
  const pageToLoad = window.location.hash.slice(1); // URL fragment
  document.getElementById('placeholder').innerHTML = load(pageToLoad);
});
</script>
Посібник з коду
Щоб робот Googlebot мав доступ до URL, рекомендуємо реалізувати URL за допомогою History API:
<nav>
  <ul>
    <li><a href="/products">Our products</a></li>
    <li><a href="/services">Our services</a></li>
  </ul>
</nav>

<h1>Welcome to example.com!</h1>
<div id="placeholder">
  <p>Learn more about <a href="/products">our products</a> and <a href="/services">our services</a></p>
</div>
<script>
function goToPage(event) {
  event.preventDefault(); // stop the browser from navigating to the destination URL.
  const hrefUrl = event.target.getAttribute('href');
  const pageToLoad = hrefUrl.slice(1); // remove the leading slash
  document.getElementById('placeholder').innerHTML = load(pageToLoad);
  window.history.pushState({}, window.title, hrefUrl) // Update URL as well as browser history.
}

// Enable client-side routing for all links on the page
document.querySelectorAll('a').forEach(link => link.addEventListener('click', goToPage));

</script>
Посібник з коду
Правильно впроваджуйте теги link з атрибутом rel="canonical"
Тег link з атрибутом rel="canonical" можна впровадити за допомогою коду JavaScript, хоча ми не рекомендуємо цього робити. Google Пошук обробить впроваджений канонічний URL при відмальовуванні сторінки. Приклад впровадження тегу link з атрибутом rel="canonical" за допомогою коду JavaScript наведено нижче:
fetch('/api/cats/' + id)
  .then(function (response) { return response.json(); })
  .then(function (cat) {
    // creates a canonical link tag and dynamically builds the URL
    // e.g. https://example.com/cats/simba
    const linkTag = document.createElement('link');
    linkTag.setAttribute('rel', 'canonical');
    linkTag.href = 'https://example.com/cats/' + cat.urlFriendlyName;
    document.head.appendChild(linkTag);
  });
Посібник з коду
Будьте обережні при роботі з тегами meta robots
За допомогою тегу meta з атрибутом robots ви можете заборонити Google індексувати певну сторінку або переходити за посиланнями. Наприклад, Googlebot не буде обробляти сторінку, якщо в її верхній частині є такий тег meta:
<!-- Google won't index this page or follow links on this page -->
<meta name="robots" content="noindex, nofollow">
Посібник з коду
Щоб додати на сторінку тег meta з атрибутом robots або змінити його, можна використовувати JavaScript. У прикладі нижче показано, як змінити тег meta з атрибутом robots у коді JavaScript, щоб заборонити індексування сторінки у випадках, коли запит API не повертає контент.
fetch('/api/products/' + productId) .then(function (response) { return response.json(); }) .then(function (apiResponse) { if (apiResponse.isError) { // get the robotsmetatag var metaRobots = document.querySelector('meta[name="robots"]'); // if there was no robotsmetatag, add one if (!metaRobots) { metaRobots = document.createElement('meta'); metaRobots.setAttribute('name', 'robots'); document.head.appendChild(metaRobots); } // tell Google to exclude this page from the index metaRobots.setAttribute('content', 'noindex'); // display an error message to the user errorMsg.textContent = 'This product is no longer available'; return; } // display product information // ... });
Посібник з коду
Застосовуйте тривале кешування
Щоб зменшити кількість мережевих запитів і споживання ресурсів, робот Googlebot активно використовує кешований контент. Оскільки WRS може ігнорувати заголовки кешування, це іноді призводить до використання застарілих ресурсів JavaScript або CSS. Щоб уникнути цієї проблеми, можна включити в назву файлу цифровий відбиток контенту, наприклад так: main.2bb85551.js. Цифровий відбиток залежить від вмісту файлу, тому при кожній зміні файлу для нього створюється нова назва. Ознайомтеся з посібником зі стратегій довгострокового кешування від web.dev.
Використовуйте структуровані дані
Якщо на вашому сайті є структуровані дані, ви можете створити код JSON-LD і впровадити його на сторінки за допомогою JavaScript. Обов’язково перевіряйте результати своєї роботи на наявність помилок.
Дотримуйтеся рекомендацій щодо роботи з веб-компонентами
Робот Googlebot підтримує веб-компоненти. Коли він виконує відмальовування сторінки, то не враховує вміст Shadow DOM і Light DOM, тобто йому доступний тільки контент, який стає видимим після відображення HTML. Дізнатися, як робот Googlebot інтерпретує контент після його відмальовування, можна за допомогою перевірки розширених результатів або інструменту перевірки URL в Search Console.
Якщо вміст не видно після виконання відмальовування HTML-коду, Googlebot не зможе включити його в індекс.
У наведеному нижче прикладі створюється веб-компонент, який відмальовує свій контент Light DOM всередині контенту Shadow DOM. Перевірити, чи видно вміст обох цих типів після процедури відображення HTML, можна за допомогою елемента Slot.
<script>
  class MyComponent extends HTMLElement {
    constructor() {
      super();
      this.attachShadow({ mode: 'open' });
    }

    connectedCallback() {
      let p = document.createElement('p');
      p.innerHTML = 'Hello World, this is shadow DOM content. Here comes the light DOM: <slot></slot>';
      this.shadowRoot.appendChild(p);
    }
  }

  window.customElements.define('my-component', MyComponent);
</script>

<my-component>
  <p>This is light DOM content. It's projected into the shadow DOM.</p>
  <p>WRS renders this content as well as the shadow DOM content.</p>
</my-component>
Googlebot проіндексує цей контент після його відображення:
<my-component>
  Hello World, this is shadow DOM content. Here comes the light DOM:
  <p>This is light DOM content. It's projected into the shadow DOM<p>
  <p>WRS renders this content as well as the shadow DOM content.</p>
</my-component>
Застосовуйте відкладене завантаження для зображень
Зображення можуть вимагати високої пропускної здатності та сповільнювати завантаження ресурсів. Радимо використовувати відкладене завантаження, щоб графічні файли завантажувалися тільки якщо їх повинен побачити користувач. Щоб оптимізувати відкладене завантаження для пошукових систем, дотримуйтесь спеціальних рекомендацій.
Зробіть сайт доступним для всіх
Створюйте сторінки для користувачів, а не тільки для пошукових систем. При розробці сайту враховуйте потреби відвідувачів. Зокрема, у них можуть бути браузери, які не підтримують JavaScript (якщо використовується програма для читання з екрана або старий телефон). Один з найпростіших способів перевірити доступність сайту — відкрити його в звичайному браузері з відключеною підтримкою JavaScript або в текстовому браузері (наприклад, Lynx). Перегляд сайту в текстовому режимі також дозволяє виявити інший контент, який важко виявити роботу Googlebot, наприклад текст на зображеннях.