У пошуку буде легше знайти набір даних, якщо додати інформацію про нього у вигляді структурованих даних, таких як назва, опис, ім’я автора та позначення формату. Google прагне спростити пошук наборів даних з різних областей, включаючи медицину та біологію, соціальні науки, машинне навчання та багато іншого. Тому ми рекомендуємо використовувати стандартизовані метадані, зокрема описані на сайті schema.org.
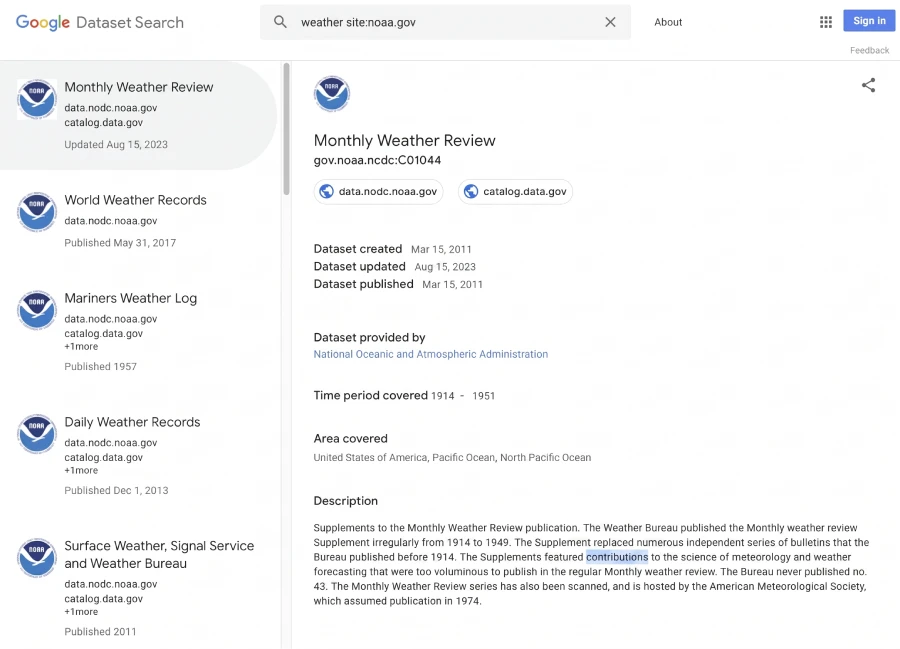
Приклади наборів даних:
- таблиця або CSV-файл з певною інформацією;
- систематизована група таблиць;
- файл у пропрієтарному форматі, що містить певні дані;
- група файлів, які в сукупності представляють корисний набір даних;
- структурований об’єкт з даними в іншому форматі, який можна завантажити в спеціальний інструмент для обробки;
- дані, отримані за допомогою зйомки зображень;
- файли машинного навчання, наприклад, визначення структур нейронної мережі або параметри навчання.
Як додати структуровані дані
Структуровані дані — стандартизований формат, який дозволяє надавати пошуковим системам інформацію про сторінку та класифікувати її вміст. Детальніше про принципи роботи структурованих даних…
Нижче в загальних рисах описано, як створити, перевірити та додати на сайт структуровані дані.
- Додайте обов’язкові властивості. Дізнайтеся, в яких частинах сторінки потрібно розміщувати структуровані дані обраного вами формату.
- Дотримуйтесь рекомендацій.
- Перевірте свій код за допомогою інструменту перевірки розширених результатів. Якщо будуть виявлені критичні помилки, усуньте їх. Ми також рекомендуємо усунути некритичні помилки, зазначені в інструменті. Це може призвести до підвищення якості структурованих даних, хоча сторінки будуть придатні для створення розширених результатів і без цього.
- Опублікуйте сторінку й за допомогою інструменту перевірки URL з’ясуйте, як вона виглядає для робота Googlebot. Переконайтеся, що доступ Google до сторінки не заблоковано файлом robots.txt або метатегом
noindexі авторизація на ній не потрібна. Якщо все в порядку, то запросіть повторне сканування ваших URL. - Надішліть нам файл Sitemap, щоб інформувати нас про зміни на сайті. Надсилання такого файлу можна автоматизувати за допомогою Search Console Sitemap API.
Як видалити набір даних з результатів пошуку наборів даних
Якщо ви не хочете, щоб набір даних показувався в результатах пошуку Google, вкажіть за допомогою тегу robots meta, як його слід індексувати. Нагадуємо, що перш ніж внесені вами зміни відобразяться в Пошуку наборів даних, може пройти кілька днів або навіть тижнів (залежно від розкладу сканування).
Наш підхід до розмітки наборів даних
Google розпізнає розмітку schema.org Dataset або аналогічні елементи розмітки для вебсторінок у форматі DCAT, розроблені організацією W3C. Також ми проводимо експеримент із підтримки структурованих даних у форматі CSVW від W3C і в міру виходу нових рекомендацій щодо цієї розмітки плануємо змінювати принципи її обробки відповідно до них. Більш детальна інформація доступна в цій статті.
Приклади
У цьому розділі наведені приклади кодів з використанням синтаксису JSON-LD і schema.org (рекомендований варіант) для наборів даних в інструменті перевірки розширених результатів. Аналогічну термінологію schema.org можна використовувати для форматів RDFa 1.1 і Microdata. Для опису метаданих також можна використовувати словник DCAT від W3C. Приклади коду нижче базуються на реальному описі набору даних.
<html>
  <head>
    <title>NCDC Storm Events Database</title>
    <script type="application/ld+json">
    {
      "@context":"https://schema.org/",
      "@type":"Dataset",
      "name":"NCDC Storm Events Database",
      "description":"Storm Data is provided by the National Weather Service (NWS) and contain statistics on...",
      "url":"https://catalog.data.gov/dataset/ncdc-storm-events-database",
      "sameAs":"https://gis.ncdc.noaa.gov/geoportal/catalog/search/resource/details.page?id=gov.noaa.ncdc:C00510",
      "identifier": ["https://doi.org/10.1000/182",
                     "https://identifiers.org/ark:/12345/fk1234"],
      "keywords":[
         "ATMOSPHERE > ATMOSPHERIC PHENOMENA > CYCLONES",
         "ATMOSPHERE > ATMOSPHERIC PHENOMENA > DROUGHT",
         "ATMOSPHERE > ATMOSPHERIC PHENOMENA > FOG",
         "ATMOSPHERE > ATMOSPHERIC PHENOMENA > FREEZE"
      ],
      "license" : "https://creativecommons.org/publicdomain/zero/1.0/",
      "isAccessibleForFree" : true,
      "hasPart" : [
        {
          "@type": "Dataset",
          "name": "Sub dataset 01",
          "description": "Informative description of the first subdataset...",
          "license" : "https://creativecommons.org/publicdomain/zero/1.0/",
          "creator":{
             "@type":"Organization",
             "name": "Sub dataset 01 creator"
          }
        },
        {
          "@type": "Dataset",
          "name": "Sub dataset 02",
          "description": "Informative description of the second subdataset...",
          "license" : "https://creativecommons.org/publicdomain/zero/1.0/",
          "creator":{
             "@type":"Organization",
             "name": "Sub dataset 02 creator"
          }
        }
      ],
      "creator":{
         "@type":"Organization",
         "url": "https://www.ncei.noaa.gov/",
         "name":"OC/NOAA/NESDIS/NCEI > National Centers for Environmental Information, NESDIS, NOAA, U.S. Department of Commerce",
         "contactPoint":{
            "@type":"ContactPoint",
            "contactType": "customer service",
            "telephone":"+1-828-271-4800",
            "email":"ncei.orders@noaa.gov"
         }
      },
      "funder":{
         "@type": "Organization",
         "sameAs": "https://ror.org/00tgqzw13",
         "name": "National Weather Service"
      },
      "includedInDataCatalog":{
         "@type":"DataCatalog",
         "name":"data.gov"
      },
      "distribution":[
         {
            "@type":"DataDownload",
            "encodingFormat":"CSV",
            "contentUrl":"https://www.ncdc.noaa.gov/stormevents/ftp.jsp"
         },
         {
            "@type":"DataDownload",
            "encodingFormat":"XML",
            "contentUrl":"https://gis.ncdc.noaa.gov/all-records/catalog/search/resource/details.page?id=gov.noaa.ncdc:C00510"
         }
      ],
      "temporalCoverage":"1950-01-01/2013-12-18",
      "spatialCoverage":{
         "@type":"Place",
         "geo":{
            "@type":"GeoShape",
            "box":"18.0 -65.0 72.0 172.0"
         }
      }
    }
    </script>
  </head>
  <body>
  </body>
</html>
Правила
На сайті повинні дотримуватися вимог до структурованих даних. Крім того, радимо дотримуватися рекомендацій щодо файлів Sitemap, а також джерел і походження даних.
Рекомендації щодо файлів Sitemap
Щоб допомогти Google знайти ваші URL, використовуйте файли Sitemap. Завдяки цим файлам і розмітці sameAs можна вказати, як знайти описи наборів даних на сайті.
Якщо ви розміщуєте набори даних у сховищі, швидше за все, у вас є два типи сторінок: канонічні (цільові) для кожного набору і сторінки зі списками наборів (наприклад, групи наборів або результати пошуку). Рекомендуємо додавати структуровані дані про набори на канонічні сторінки. Якщо ви додали розмітку на сторінку з кількома копіями набору даних (наприклад, з результатами пошуку), використовуйте властивість sameAs, щоб вказати канонічну URL-адресу.
Рекомендації щодо джерел та походження
Відкриті набори даних часто створюються на основі інших наборів, агрегуються та повторно публікуються. Ми підготували основні інструкції, з яких ви дізнаєтеся, як діяти в подібних випадках. Якщо набір даних створений на основі іншого набору (наприклад, скопійований), дотримуйтесь наведених нижче рекомендацій.
- Якщо набір даних або опис публікуються повторно, вкажіть вихідні канонічні URL оригіналу за допомогою властивості
sameAs. ЕлементsameAsповинен однозначно ідентифікувати набір даних, тобто два різних набори не повинні мати однакові значенняsameAs. - Якщо раніше опублікований набір даних (включаючи його метадані) був суттєво змінений, використовуйте властивість
isBasedOn. - Якщо набір даних створено на основі декількох інших наборів, використовуйте властивість
isBasedOn. - Щоб вказати відповідні цифрові ідентифікатори об’єкта (ЦИО) або компактні ідентифікатори, скористайтеся властивістю
identifier. Якщо в наборі даних представлено більше одного ідентифікатора, додайте кілька властивостей identifier. Якщо ви використовуєте JSON-LD, застосовуйте синтаксис списку JSON.
Ми продовжуємо вдосконалювати ці рекомендації, зокрема щодо джерел, версій і дат, які відносяться до часових рядів. У цьому нам допомагають ваші відгуки. Приєднуйтесь до дискусій!
Рекомендації щодо текстових властивостей
Google Пошук наборів даних у будь-якому випадку обробляє лише перші 5000 символів тексту у властивості. Намагайтеся не перевищувати це обмеження. Назви та заголовки зазвичай складаються лише з кількох слів або одного короткого речення.
Відомі помилки та попередження
Інструмент перевірки розширених результатів і схожі сервіси можуть знаходити помилки та показувати попередження, на які не варто звертати уваги. Системам перевірки може знадобитися також контактна інформація, зокрема властивість contactType. Приклади значень: customer service, emergency, journalist, newsroom, public engagement. Також можна ігнорувати повідомлення про те, що csvw:Table – недопустиме значення властивості mainEntity.
Типи структурованих даних
Щоб ваш контент міг відображатися в розширених результатах, необхідно встановити всі обов’язкові властивості. Ви також можете додати рекомендовані властивості, щоб користувачам було зручніше вивчати інформацію.
Для перевірки розмітки рекомендуємо використовувати інструмент перевірки розширених результатів.
Ваша основна мета — вказати інформацію про набір даних (його метадані) і описати його вміст. Наприклад, у метаданих вказана тема набору, вимірювані змінні, творець набору тощо. При цьому конкретні значення змінних не вказуються.
Dataset
Повний опис типу Dataset наведено на сторінці schema.org/Dataset.
Ви можете додати додаткову інформацію про публікацію набору даних, наприклад ліцензію, час публікації, ЦИО або значення sameAs, що вказує на канонічну версію набору в іншому сховищі. Щоб вказати інформацію про походження та ліцензію, використовуйте елементи identifier, license та sameAs.
Google підтримує наступні властивості:
| Обов’язкові властивості | |
|---|---|
description | Короткий опис набору даних. Правила
|
name | Інформативна назва набору даних. Приклад: «Висота снігового покриву в Північній півкулі». Правила
Правильно: Неправильно: |
| Рекомендовані властивості | |
|---|---|
alternate | Альтернативні імена, які використовувалися для посилання на цей набір даних: псевдоніми або скорочення. Приклад у форматі JSON-LD: "name": "The Quick, Draw! Dataset" "alternateName": ["Quick Draw Dataset", "quickdraw-dataset"] |
creator |
Творець або автор цього набору даних. Для ідентифікації окремих осіб використовуйте у властивості "creator": [ { "@type": "Person", "sameAs": "https://orcid.org/0000-0000-0000-0000", "givenName": "Jane", "familyName": "Foo", "name": "Jane Foo" }, { "@type": "Person", "sameAs": "https://orcid.org/0000-0000-0000-0001", "givenName": "Jo", "familyName": "Bar", "name": "Jo Bar" }, { "@type": "Organization", "sameAs": "https://ror.org/xxxxxxxxx", "name": "Fictitious Research Consortium" } ] |
citation |
Посилання на наукові статті, які постачальник даних рекомендує процитувати на додаток до основного набору. Додайте цитування в набір даних разом із такими властивостями, як "citation": "https://doi.org/10.1111/111" "citation": "https://identifiers.org/pubmed:11111111" "citation": "https://identifiers.org/arxiv:0111.1111v1" "citation": "Doe J (2014) Influence of X ... https://doi.org/10.1111/111" Додаткові правила
|
funder |
Ім’я спонсора або назва організації-спонсора. Для ідентифікації окремих осіб використовуйте у властивості "funder": [ { "@type": "Person", "sameAs": "https://orcid.org/0000-0000-0000-0002", "givenName": "Jane", "familyName": "Funder", "name": "Jane Funder" }, { "@type": "Organization", "sameAs": "https://ror.org/yyyyyyyyy", "name": "Fictitious Funding Organization" } ] |
has або is | Якщо набір даних складається з декількох невеликих наборів, вкажіть це за допомогою властивості "hasPart" : [ { "@type": "Dataset", "name": "Sub dataset 01", "description": "Informative description of the first subdataset...", "license": "https://creativecommons.org/publicdomain/zero/1.0/", "creator": { "@type":"Organization", "name": "Sub dataset 01 creator" } }, { "@type": "Dataset", "name": "Sub dataset 02", "description": "Informative description of the second subdataset...", "license": "https://creativecommons.org/publicdomain/zero/1.0/", "creator": { "@type":"Organization", "name": "Sub dataset 02 creator" } } ] "isPartOf" : "https://example.com/aggregate_dataset" |
identifier |
Ідентифікатор набору даних, наприклад ЦИО або компактний. Якщо в наборі даних не один ідентифікатор, додайте кілька властивостей |
is | Вказує, чи є набір даних безкоштовним. |
keywords | Ключові слова, що характеризують набір даних. |
license |
Ліцензія, за якою поширюється набір даних. Приклади наведені нижче. "license" : "https://creativecommons.org/publicdomain/zero/1.0/" "license" : { "@type": "CreativeWork", "name": "Custom license", "url": "https://example.com/custom_license" } Додаткові правила
|
measurement | Технологія або методологія, що використовується в наборі даних, яка відповідає змінним, описаним у властивості |
same | URL вебсторінки з детальною інформацією, яка дозволяє однозначно ідентифікувати набір даних. |
spatial | Ви можете вказати одну точку, яка описує просторовий аспект набору даних. Використовуйте цю властивість, тільки якщо набір має просторовий вимір. Наприклад, це може бути точка, де були зібрані всі вимірювання, або координати обмежувального паралелепіпеда площі. Точки "spatialCoverage:" { "@type": "Place", "geo": { "@type": "GeoCoordinates", "latitude": 39.3280, "longitude": 120.1633 } } Фігури Використовуйте елемент "spatialCoverage:" { "@type": "Place", "geo": { "@type": "GeoShape", "box": "39.3280 120.1633 40.445 123.7878" } } Координати у властивостях Назви місць "spatialCoverage:" "Tahoe City, CA" |
temporal | Період часу, до якого відносяться дані в наборі. Використовуйте цю властивість, тільки якщо набір має часовий вимір. Для опису періодів і моментів часу в schema.org використовується стандарт ISO 8601. Ви можете вказати дати іншим способом, якщо він підходить краще. Позначайте необмежені періоди двома крапками ( Дата "temporalCoverage" : "2008" Період часу "temporalCoverage" : "1950-01-01/2013-12-18" Необмежений період "temporalCoverage" : "2013-12-19/.." |
variable |
Змінна в наборі даних, вимірювання якої виконується. Наприклад, це може бути температура або тиск. |
version | Номер версії набору. |
url | Адреса сторінки з описом набору даних. |
Data
Повний опис типу DataCatalog наведено на сторінці schema.org/DataCatalog.
Набори даних часто публікуються в сховищах, що містять безліч інших наборів. Один і той самий набір може знаходитися в декількох сховищах. Вкажіть потрібний каталог даних за допомогою прямого посилання на нього. Використовуйте властивості, перераховані нижче.
| Рекомендовані властивості | |
|---|---|
included | Каталог, в якому розміщений набір даних. |
Data
Повний опис типу DataDownload наведено на сторінці schema.org/DataDownload. Якщо набір даних можна завантажити, вкажіть не лише властивості Dataset, а й властивості DataDownload, перелічені нижче.
Властивість distribution описує, як отримати набір даних, оскільки URL набору часто вказує на цільову сторінку з описом набору, а не на сторінку для завантаження. Властивість distribution вказує, де завантажити дані та в якому форматі. У цієї властивості може бути кілька значень. Наприклад, версія у форматі CSV може бути доступна за одним URL, а версія у форматі Excel – за іншим.
| Обов’язкові властивості | |
|---|---|
distribution. | Посилання для завантаження. |
| Рекомендовані властивості | |
|---|---|
distribution | Опис місця, з якого завантажується набір даних, і формату файлу для завантаження. |
distribution. | Формат дистрибутива. |
Табличні набори даних
Табличний — це набір даних, організований переважно у вигляді сітки з рядків і стовпців. Для сторінок, що містять табличні набори даних, можна створити більш явну розмітку на основі основних інструкцій, наведених вище. В даний час Google може обробляти дані у форматі CSVW (CSV on the Web), розміщені на HTML-сторінці паралельно з табличним вмістом, призначеним для користувачів.
Нижче наведено приклад коду у форматі CSVW JSON-LD для невеликої таблиці. Інструмент перевірки розширених результатів попередить вас про деякі помилки, які можна ігнорувати.
<html>
  <head>
    <title>American Humane Association</title>
    <script type="application/ld+json">
    {
      "@context": ["https://schema.org", {"csvw": "https://www.w3.org/ns/csvw#"}],
      "@type": "Dataset",
      "name":"AMERICAN HUMANE ASSOCIATION",
      "description": "ProPublica's Nonprofit Explorer lets you view summaries of 2.2 million tax returns from tax-exempt organizations and see financial details such as their executive compensation and revenue and expenses. You can browse raw IRS data released since 2013 and access over 9.4 million tax filing documents going back as far as 2001.",
      "publisher": {
        "@type": "Organization",
        "name": "ProPublica"
      },
      "mainEntity" : {
        "@type" : "csvw:Table",
        "csvw:tableSchema": {
          "csvw:columns": [
            {
              "csvw:name": "Year",
              "csvw:datatype": "string",
              "csvw:cells": [
                {
                  "csvw:value": "2024",
                  "csvw:primaryKey": "2024"
                },
                {
                  "csvw:value": "2024",
                  "csvw:primaryKey": "2024"
                }]
            },
            {
              "csvw:name": "Organization name",
              "csvw:datatype": "string",
              "csvw:cells": [
                {
                  "csvw:value": "AMERICAN HUMANE ASSOCIATION",
                  "csvw:primaryKey": "2024"
                },
                {
                  "csvw:value": "AMERICAN HUMANE ASSOCIATION",
                  "csvw:primaryKey": "2024"
                }]
            },
            {
              "csvw:name": "Organization address",
              "csvw:datatype": "string",
              "csvw:cells": [
                {
                  "csvw:value": "1400 16TH STREET NW",
                  "csvw:primaryKey": "2024"
                },
                {
                  "csvw:value": "1400 16TH STREET NW",
                  "csvw:primaryKey": "2024"
                }]
            },
            {
              "csvw:name": "Organization NTEE Code",
              "csvw:datatype": "string",
              "csvw:cells": [
                {
                  "csvw:value": "D200",
                  "csvw:notes": "Animal Protection and Welfare",
                  "csvw:primaryKey": "2024"
                },
                {
                  "csvw:value": "D200",
                  "csvw:notes": "Animal Protection and Welfare",
                  "csvw:primaryKey": "2024"
                }]
            },
            {
              "csvw:name": "Total functional expenses ($)",
              "csvw:datatype": "integer",
              "csvw:cells": [
                {
                  "csvw:value": "13800212",
                  "csvw:primaryKey": "2024"
                },
                {
                  "csvw:value": "13800212",
                  "csvw:primaryKey": "2024"
                }]
            }]
        }
      }
    }
    </script>
  </head>
  <body>
  </body>
</html>
Збір статистики за розширеними результатами в Search Console
За допомогою Search Console ви можете збирати дані про ефективність сторінок вашого ресурсу в Пошуку Google. Вам не обов’язково реєструватися в цьому сервісі, щоб ваші сторінки потрапили в результати пошуку. Однак це дозволить дізнатися, як роботи Google сприймають сайт, і спростити їм його обробку. Рекомендуємо перевіряти інформацію в Search Console в наступних випадках:
- Після першого розміщення структурованих даних
- Після випуску нових шаблонів або оновлення коду
- При регулярному аналізі трафіку
Після першого розміщення структурованих даних
Коли ваші сторінки будуть проіндексовані, перевірте їх на наявність помилок за допомогою звіту про стан розширених результатів. Бажано, щоб кількість об’єктів з правильною розміткою зросла, а кількість об’єктів з помилками — ні. Якщо в структурованих даних будуть виявлені помилки, вживайте наступних заходів:
- Усуньте проблеми в об’єктах.
- Перевірте виправлену сторінку, щоб дізнатися, чи виявляються помилки.
- Запитайте перевірку ресурсу, використовуючи звіт про стан розширених результатів.
Після випуску нових шаблонів або оновлення коду
Якщо ви внесли значні зміни на сайт, перевірте, чи не збільшилася кількість недійсних об’єктів, пов’язаних зі структурованими даними.
- Збільшилася кількість недійсних об’єктів? Можливо, ви створили шаблон, з яким щось не так, або наявний шаблон використовується некоректно.
- Кількість дійсних елементів зменшилася, але кількість недійсних не збільшилася? Можливо, на ваших сторінках не розміщені структуровані дані. З’ясувати, з чим пов’язані помилки, можна за допомогою інструменту перевірки URL.
При регулярному аналізі трафіку
Аналізувати трафік сайту з Google Пошуку можна за допомогою звіту про ефективність. З цього звіту ви дізнаєтеся, як часто сторінка з’являється в Пошуку у вигляді розширеного результату, з якою регулярністю користувачі натискають на неї і яка її середня позиція в результатах пошуку. Цю інформацію також можна автоматично отримати за допомогою Search Console API.
Усунення несправностей
Якщо у вас виникли труднощі з додаванням або налагодженням структурованих даних, вам допоможуть ресурси та інформація, доступні за наведеними нижче посиланнями.
- Якщо ви використовуєте систему управління контентом (CMS) або доручили налаштування сайту інший людині, зверніться за допомогою до неї або розробника CMS. Не забудьте переслати йому повідомлення про проблему, отримані вами в Search Console.
- Google не гарантує відображення вашого контенту в результатах пошуку, які формуються на основі структурованих даних. Можливі причини, з яких ваші матеріали можуть не відображатися у вигляді розширених результатів, перераховані в загальних рекомендаціях щодо використання структурованих даних.
- Ознайомтеся зі списком типових помилок у структурованих даних та звітом про структуровані дані, які неможливо обробити, і перевірте, чи правильно ви додали розмітку.
- Якщо ми вжили заходів щодо сторінки вручну, неприпустимі структуровані дані на ній будуть проігноровані доти, доки ви не виправите код. При цьому сама сторінка може з’являтися в результатах пошуку й далі. Щоб усунути проблеми зі структурованими даними, скористайтеся звітом про заходи, вжиті вручну.
- Ще раз вивчіть рекомендації, щоб з’ясувати, чи відповідає їм ваш контент. Проблема може бути пов’язана зі спамом у контенті або розмітці, а не з помилками в синтаксисі. Тоді її не вдасться виявити за допомогою інструменту перевірки розширених результатів.
- Дізнайтеся, що може спричинити відсутність розширених результатів або зменшення їх загальної кількості.
- Робот Googlebot сканує та індексує сторінки не одразу після оновлення контенту. З моменту публікації сторінки може пройти кілька днів, поки Google не виявить і просканує її. Ми зібрали на окремій сторінці відповіді на поширені запитання про сканування та індексацію.
- При необхідності ставте запитання на форумі Центру Пошуку Google
Набір даних відсутній у результатах пошуку
error Причина проблеми. Сторінка ще не просканована або на ній немає розмітки, що відноситься до набору даних.
done Як усунути проблему
- За допомогою інструменту перевірки розширених результатів протестуйте сторінку, яка повинна відображатися в результатах пошуку за набором даних (для цього потрібно вказати в інтерфейсі інструменту її URL). Якщо з’являється повідомлення «Цей інструмент перевірки не знаходить на вибраній сторінці вміст, який можна показати в розширених результатах пошуку» або «Для показу розширених результатів підходить не вся розмітка», значит на сторінці немає розмітки для набору даних або вона впроваджена некоректно. Про те, як вирішити цю проблему, читайте в розділі Як додавати структуровані дані.
- Якщо на сторінці є структуровані дані, можливо, вона ще не оброблена Google. Спробуйте перевірити статус її сканування в Search Console.
Логотип компанії відсутній або неправильно відображається в результатах пошуку
error Причина проблеми. На сторінці може бути відсутня розмітка schema.org для логотипу компанії, або ваша компанія не зареєстрована в Google.
done Як усунути проблему
- Додайте на сторінку структуровані дані для логотипів.
- Надішліть дані про свою компанію в Google.